写在前面
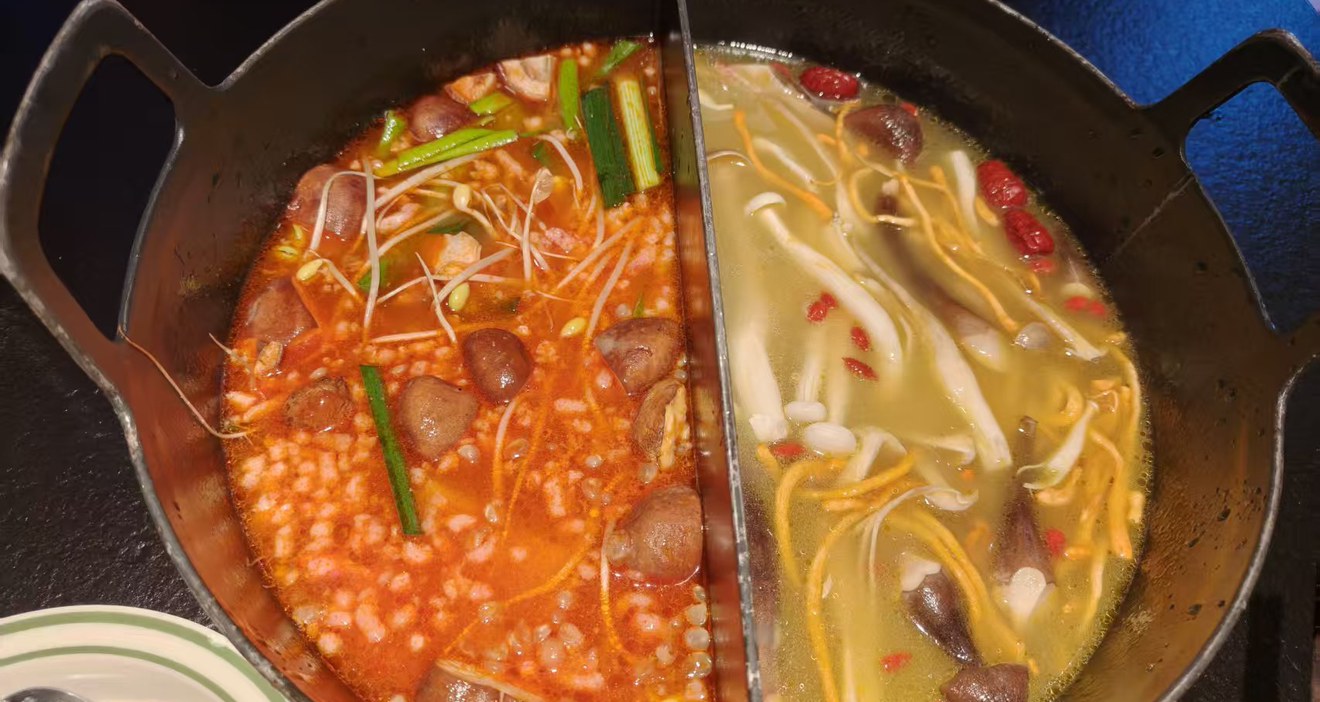
这周试了试 Orca,也读了 mzCache,顺便开始折腾 Sereno 的复现。周末还去蛇口吃了一顿贵州酸汤火锅,不过实际吃完觉得比较一般,只能给三颗星。
本周工具:Orca
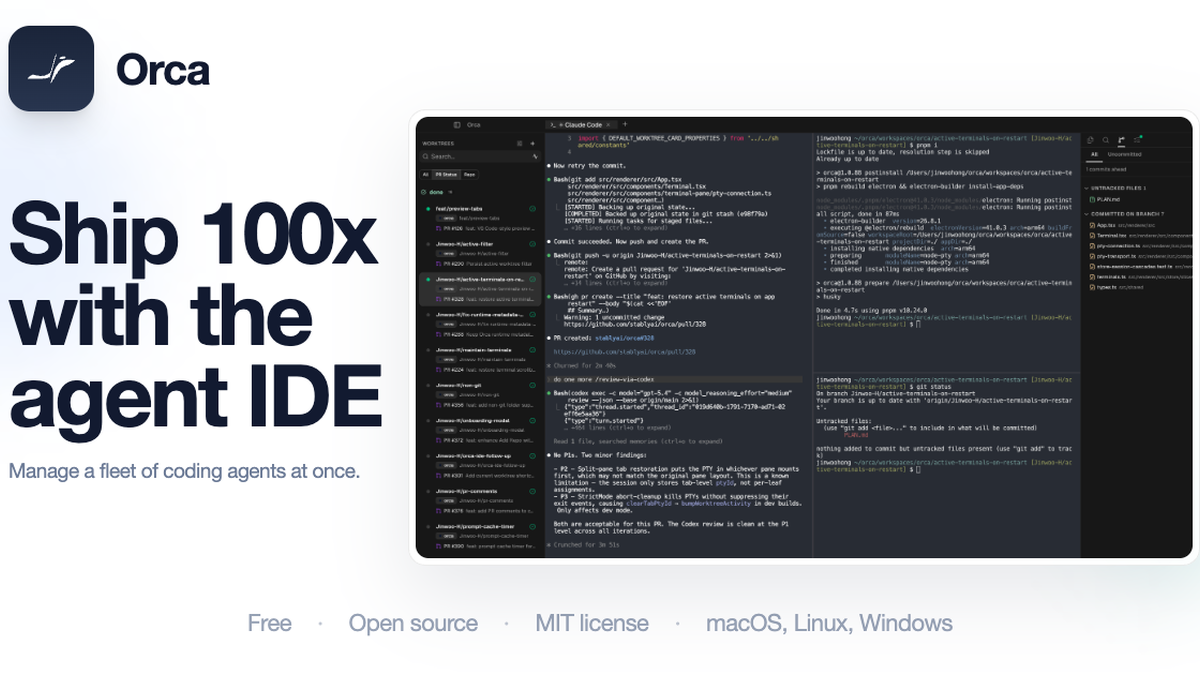
Orca 把自己称为 Agent Development Environment。它不是新的模型或 coding agent,而是把 Codex、Claude Code、OpenCode 等命令行 agent,以及终端、diff、浏览器和 Git 工作流集中到同一个应用里。
它最吸引我的地方,是默认把并行工作当作一等公民:每个任务运行在独立的 Git worktree 中,可以让多个 agent 同时探索不同方案,最后再比较和合并结果,而不必反复 stash 或切换分支。
- 多 agent 并行。 同一项目可以同时运行多个 coding agents,每个任务互不干扰。
- 完整开发闭环。 终端、代码差异、浏览器、文件和任务状态都留在一个界面里。
- 沿用已有订阅。 可以直接接入已经在使用的 agent CLI,不需要更换模型服务。
- 开源且跨平台。 项目采用 MIT License,支持 macOS、Windows 和 Linux。
如果工作流已经从“偶尔问一次 agent”变成“同时调度多个 agent”,Orca 值得试一试。它解决的不是单次生成质量,而是并行任务的隔离、追踪和收尾成本。
本周论文:mzCache
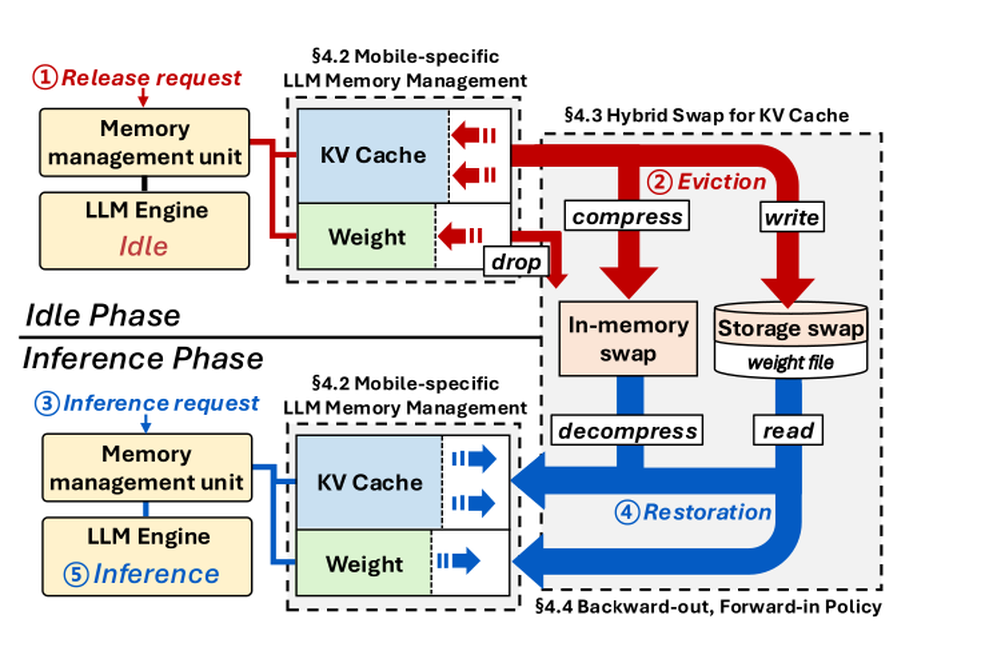
mzCache: On-Device LLM Memory Management under Multitasking 是一篇 MobiCom 2026 论文。它关注一个很具体的移动端问题:用户切换到其他应用后,系统可能在内存压力下驱逐 LLM 的模型权重与 KV cache;等下一次请求到来,再从存储恢复或重新计算,会显著拉长首 token 延迟。
mzCache 的核心不是“永远占住内存”,而是让内存能够按压力弹性释放,同时始终为快速恢复做好准备:
- 把权重和 KV cache 拆成细粒度共享缓冲区,只驱逐真正需要释放的部分;
- 用 hybrid swap 同时利用内存压缩区与存储读取,平衡两条恢复路径;
- 按 backward-out、forward-in 的顺序处理层,让 GPU 先使用仍在内存中的前层开始计算,CPU 同时恢复后续数据。
论文在商业手机和多种模型上实现于 llama.cpp,相比基于存储的 partial offload,将 Time-to-First-Token 降低了 2.1–5.5 倍。我喜欢这篇工作的地方,是它没有把移动端统一内存只视作限制,而是把 CPU、GPU 和存储之间可并行恢复的机会真正利用了起来。
复现记录:Sereno
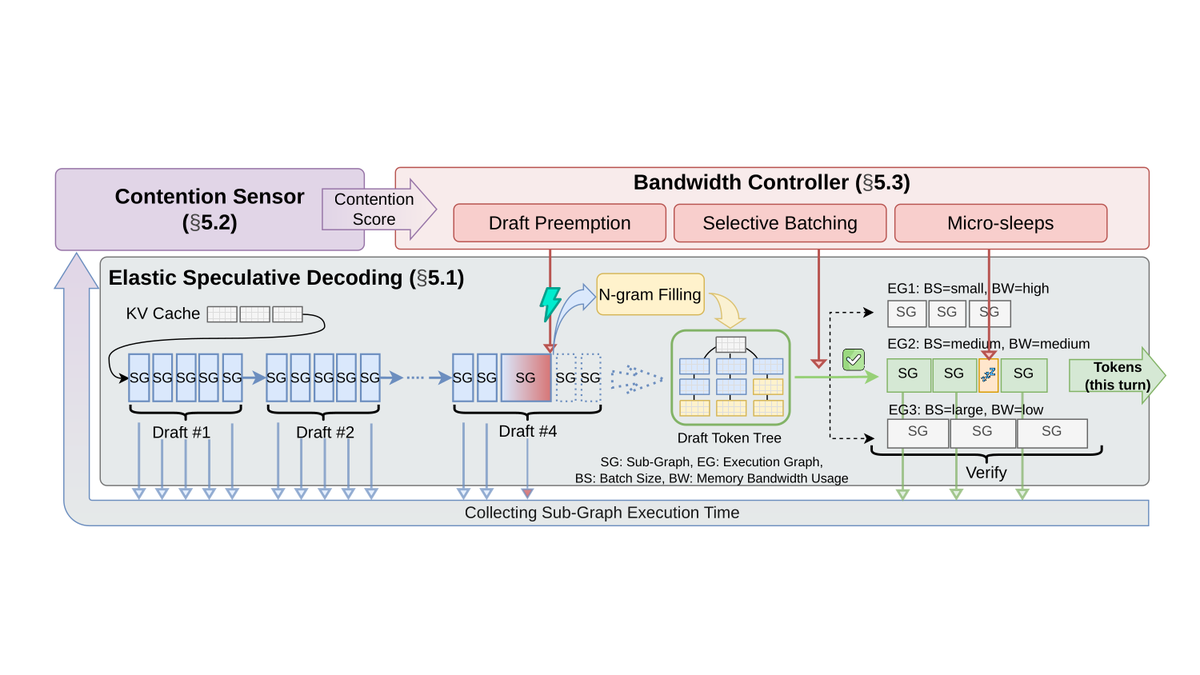
我正在尝试复现 Sereno。这篇 OSDI 2026 工作研究后台移动端 LLM 推理对前台应用的影响:NPU 的内存流量拥有较高优先级,后台推理自身的吞吐下降很小,却会让前台应用的总体 jank rate 上升 153%。
Sereno 的关键思路很巧:它不只把 speculative decoding 当作加速手段,而是把 draft 阶段拆成可中断的细粒度执行单元。系统感知到带宽争用后,可以立即中止部分 draft、调整 verification batch,并在必要时插入短暂的 micro-sleep,把内存带宽让给前台,同时保留已经完成的推理进度。
论文报告,Sereno 最多可降低 92.6% 的前台 jank(平均 58.5%),同时把 LLM 吞吐最高提升 67.9%(平均 26.4%)。复现时我想先确认三个层次:稳定触发前后台带宽争用、复现 jank 与吞吐的不对称变化,再验证细粒度 yield point 是否真的能形成可控的 Sense–Decide–Act 闭环。先把测量链路做可靠,再逐步接近完整机制。
本周一餐:酸汤初尝
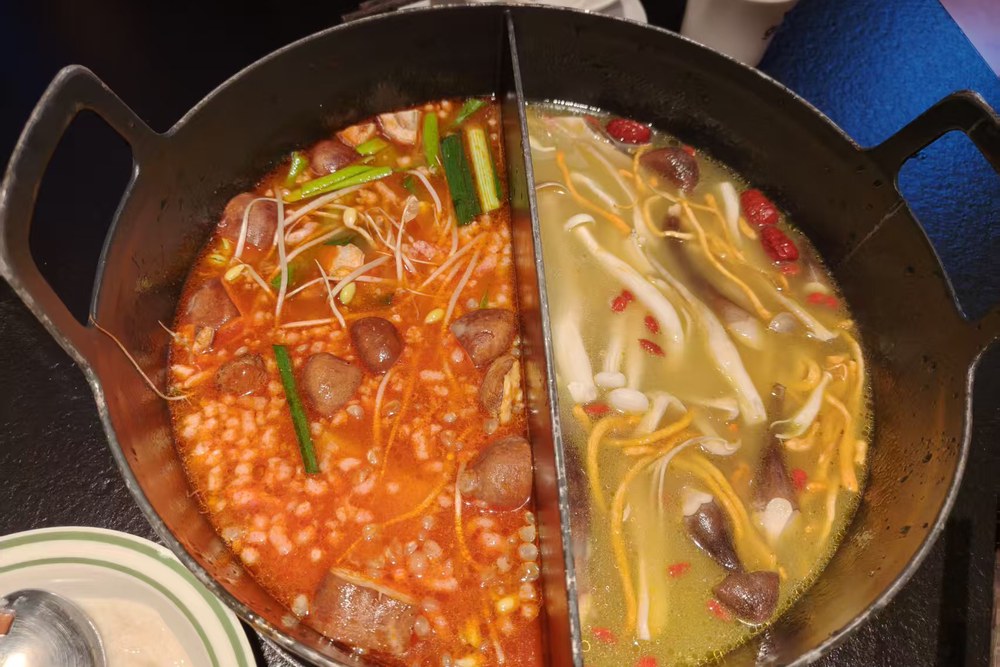
这周在蛇口吃了酸咕咕贵州酸汤火锅,点的是双拼锅,一边偏酸辣,另一边清淡一些。两种锅底各有味道,但整体并没有带来太多惊喜。
不过实际吃下来,我的评价是 ★★★☆☆。酸汤本身有辨识度,也确实开胃,但整顿饭没有留下特别强的记忆点,属于可以尝鲜、却未必会专程再去的一家。